
Backup SQL Server até 4x mais rápido, sem investir
Oito instâncias gravavam o backup SQL Server no mesmo destino e na mesma hora. Mudar horário, destino e limpeza deixou o servidor principal até 4x mais rápido.
Quando o banco de dados ou o backup SQL Server começa a demorar, a conversa quase sempre começa pelo que dá para comprar. Disco mais rápido, mais memória, um storage novo, uma ferramenta de backup com nome bonito. Às vezes é isso mesmo que resolve, e eu não tenho nada contra investimento bem feito.
Mas a maior parte dos ganhos que eu vejo no dia a dia não vem daí. Vem de alguém olhar o ambiente com atenção, achar três ou quatro coisas pequenas fora do lugar e arrumar. Nenhuma delas impressiona sozinha. Somadas, mudam o resultado.
Este mês aconteceu de novo, com o backup SQL Server de um cliente do varejo. Nenhum servidor foi trocado e nenhuma licença foi comprada. Só reorganizei os jobs que já existiam, e as quatro instâncias do servidor mais carregado passaram a fazer backup de 2,6 a 4,3 vezes mais rápido.
o que eu encontrei
O ambiente tem oito instâncias SQL Server espalhadas por quatro servidores. Cada instância tinha o seu job de backup FULL, configurado em épocas diferentes, por pessoas diferentes. Olhando um de cada vez, todos pareciam razoáveis. Olhando todos juntos, o desenho não fazia sentido.
As quatro instâncias do servidor da retaguarda começavam o backup no mesmo minuto, às 02:00, e gravavam na mesma pasta de rede. Estavam na mesma máquina, lendo dos mesmos discos e disputando a mesma placa de rede para escrever no mesmo destino. Cada uma atrapalhava as outras três.
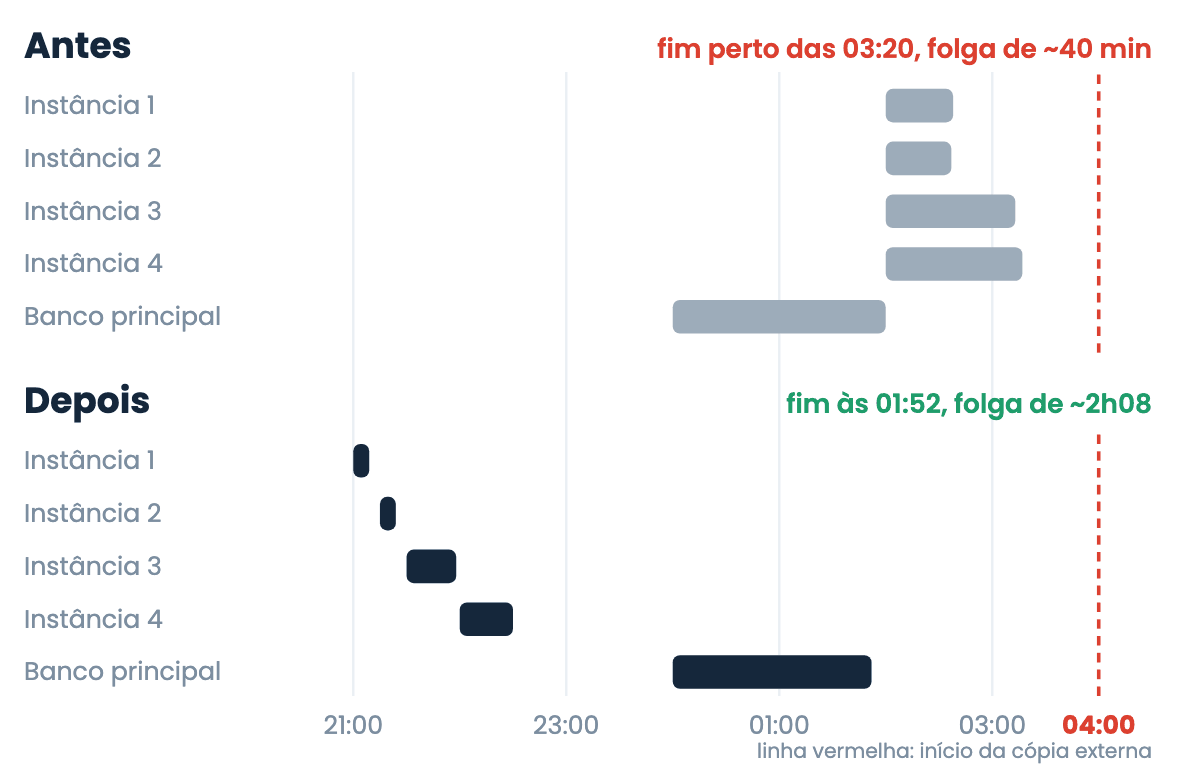
O resto também estava espalhado. Eram quatro destinos de backup distintos, sendo um deles o disco local do próprio servidor, que não entrava na cópia externa. A janela da noite terminava por volta das 03:20, e a cópia externa começava às 04:00. Sobravam uns 40 minutos de folga, e qualquer noite mais pesada engoliria essa margem.
E havia um problema mais sério, que não tinha nada a ver com velocidade.
a limpeza que apagava o backup antes de fazer o novo
Seis das oito instâncias estavam configuradas para apagar os backups antigos antes de fazer o novo. Nesses jobs, que usam a rotina gratuita do Ola Hallengren, isso é o parâmetro @CleanupMode = 'BEFORE_BACKUP'. O padrão da própria ferramenta é o contrário, AFTER_BACKUP: o arquivo antigo só sai depois que o novo terminou bem. Em algum momento, alguém tinha trocado.
Enquanto o backup funciona, ninguém percebe a diferença. O problema aparece na noite em que ele falha. O job apaga a cópia de ontem, tenta fazer a de hoje, não consegue, e o banco fica sem backup nenhum.
Não foi hipótese. Um dos bancos começou a falhar no backup por um erro de leitura no disco. O job continuou rodando toda noite, apagando a cópia anterior e falhando em seguida, e o alerta de falha não chegou a ninguém. Quando encontrei, fazia semanas que aquele banco não tinha uma única cópia. É o tipo de coisa que eu contei em seu backup nunca foi testado: o job existe, roda e está agendado, e mesmo assim não há backup.
as mudanças, uma por uma
Nada do que foi feito exige conhecimento raro. É o básico, aplicado com cuidado:
- Horários escalonados. As quatro instâncias do servidor principal passaram a começar às 21:00, 21:15, 21:30 e 22:00. Os intervalos saíram da duração medida de cada uma, para que uma termine antes da próxima começar. As outras instâncias vêm em seguida, até a meia-noite.
- Um destino só. Todos os backups vão para a mesma raiz, com uma pasta por servidor, instância e banco. Fica fácil de conferir e a cópia externa pega tudo.
- Limpeza depois do backup.
AFTER_BACKUPem todas as instâncias, com retenção de 72 horas. São três gerações guardadas, e a mais antiga só sai quando a nova está pronta. - Data e hora no nome do arquivo. Com o nome fixo, cada backup ocupa o lugar do anterior. Com data e hora, dá para saber de relance qual é de quando.
- Compressão e checksum ligados em todas. A compressão reduz o volume que atravessa a rede. O checksum faz o SQL Server conferir as páginas enquanto grava, e um backup de página corrompida falha na hora, em vez de passar como bom.
No Ola Hallengren, o miolo da chamada fica assim:
EXECUTE dbo.DatabaseBackup
    @Databases     = 'USER_DATABASES',
    @Directory     = '\\servidor-de-backup\Backup',
    @BackupType    = 'FULL',
    @Compress      = 'Y',
    @CheckSum      = 'Y',
    @NumberOfFiles = 4,
    @CleanupTime   = 72,
    @CleanupMode   = 'AFTER_BACKUP';
Mudança simples não quer dizer mudança descuidada. Antes de mexer em qualquer job, fiz um backup de emergência de todos os bancos. Cada instância ganhou um script próprio, que registra a configuração antiga antes de trocar. Esse registro é o plano de volta, e ficou pronto antes de ser preciso.
os números
A comparação é entre a primeira noite completa no padrão novo e a média das treze noites anteriores. A segunda noite repetiu os mesmos tempos.
| Instância do servidor principal | Antes (média) | Depois | Ganho |
|---|---|---|---|
| Instância 1 | 37,7 min | 8,8 min | 4,3x |
| Instância 2 | 37,0 min | 9,4 min | 3,9x |
| Instância 3 | 73,3 min | 27,5 min | 2,7x |
| Instância 4 | 76,8 min | 29,9 min | 2,6x |
O maior banco do servidor levava cerca de 48 minutos e passou a levar 13,8. A vazão de gravação de uma das instâncias subiu de 60 para 340 MB/s, no mesmo disco e na mesma rede. A diferença é que agora ela grava sozinha.
A janela da noite ficou assim:
| Antes | Depois | |
|---|---|---|
| Início | 23:00 | 21:00 |
| Fim do último backup | cerca de 03:20 | 01:52 |
| Folga até a cópia externa das 04:00 | cerca de 40 min | cerca de 2h08 |
E o banco que estava sem nenhuma cópia voltou a ter backup, junto com um banco de histórico que não aparecia em backup FULL nenhum.
Uma ressalva: não isolei cada mudança para medir o efeito dela sozinha. A compressão e os quatro arquivos por backup entraram na mesma noite que o escalonamento. Mas os números das quatro instâncias apontam para o mesmo lugar. As duas menores, que antes demoravam quase o mesmo que as grandes, foram as que mais ganharam. É o que se espera quando o problema era a fila.
o que não melhorou, e por quê
A instância do banco principal, com cerca de 600 GB, ficou praticamente igual: de 120 para 112 minutos. O limite dela é a velocidade de leitura dos discos do próprio servidor, não o destino. Resolver isso exigiria mexer no armazenamento, que é outro projeto, com outro custo.
por que o básico dá tanto resultado
Nenhuma dessas cinco mudanças está em curso avançado. Qualquer DBA sabe escalonar horário e limpar depois do backup. Neste ambiente, só faltava alguém olhar os oito jobs ao mesmo tempo e perguntar por que eles estavam daquele jeito.
É o que a manutenção de rotina tem de pouco glamouroso: não vira projeto nem apresentação para a diretoria. É acompanhar o ambiente, ver o que mudou, notar que um job está demorando o dobro do que demorava e ir atrás. Cada correção é pequena, e o efeito vai se acumulando: um backup que termina duas horas antes, um banco que volta a ter cópia, um arquivo que agora existe fora do servidor.
O investimento grande tem o seu lugar. Mas ele rende mais quando entra num ambiente que já está em ordem, porque aí você sabe exatamente qual gargalo está pagando para resolver.
por onde começar no seu ambiente
Se você cuida de SQL Server, ou é responsável por quem cuida, estas perguntas cabem numa manhã:
- A que horas termina o último backup da noite? E quanta folga sobra até a próxima rotina, que pode ser a cópia externa, a carga do BI ou o primeiro turno?
- Quantos jobs de backup começam no mesmo minuto, no mesmo servidor ou para o mesmo destino?
- A limpeza dos arquivos antigos roda antes ou depois do backup?
- Quando foi o último alerta de falha de backup que chegou em alguém? Se a resposta for "nunca", confira se o alerta funciona antes de concluir que nada falhou.
Se alguma dessas travar, vale olhar com calma. Eu faço isso no Health Check gratuito: levanto como o backup está de verdade, o que roda, quanto demora e se volta, e devolvo um retrato do que precisa mudar. Para quem quer saber se o backup aguenta um dia ruim, o caminho mais direto é a página meu backup me salvaria?.
Caso real de setembro de 2026, num cliente do varejo, com oito instâncias SQL Server em quatro servidores. Os nomes de servidores, instâncias e bancos foram omitidos. Os tempos são os registrados no histórico dos jobs.

Marcio Mandarino
DBA Oracle e SQL Server há mais de 20 anos. Atendo plantão, recuperação de incidente e gestão contínua de bancos de dados. Este artigo saiu de um laboratório que rodou antes de virar texto.

